
一場 session,我真正讓模型「寫出來」的只有 288,570 個 output tokens;同一場 session 被計費讀進去的 context 是 272,406,631 個 tokens(出自我自己記錄的逐輪用量紀錄,這場 session 78 個計費輪次全量)。
差距不是我打字打得多——我從頭到尾只打了幾十句話。差距是輪數。
Day 2 留下的是大量 context 重讀的疑問,我不先斷言它佔帳單最大一塊,只知道有這欄,不知道它為什麼會長成那樣。
這篇改用一場有完整逐輪記錄的 session,共 78 個計費輪次,沒有抽樣。Day 2 使用的彙總與歷史筆記不足以呈現逐輪變化;這次換樣本,是為了看見每輪重讀量的形狀。後文沿用原始輪次編號(如第 93 輪、第 102 輪),78 則是指納入統計的計費輪次筆數,兩套編號並不相同。
我一直以為答得長才貴,後來才注意到重讀 context 的累計量。本文的「輪」指逐輪用量紀錄裡的一筆輪次記錄;一輪可以包含多次模型請求與工具呼叫,工具呼叫數不等於 API 請求數,也不能直接換算成計費輪數。模型接續工作時會再次帶入當下的 context,工具結果若被保留,也可能成為後續請求的一部分;實際重讀量應以用量紀錄為準,不能只用工具呼叫次數推算。
逐輪用量紀錄每輪記下三個數:本輪重讀的 context、本輪真正產出的量、本輪 tool call 數。
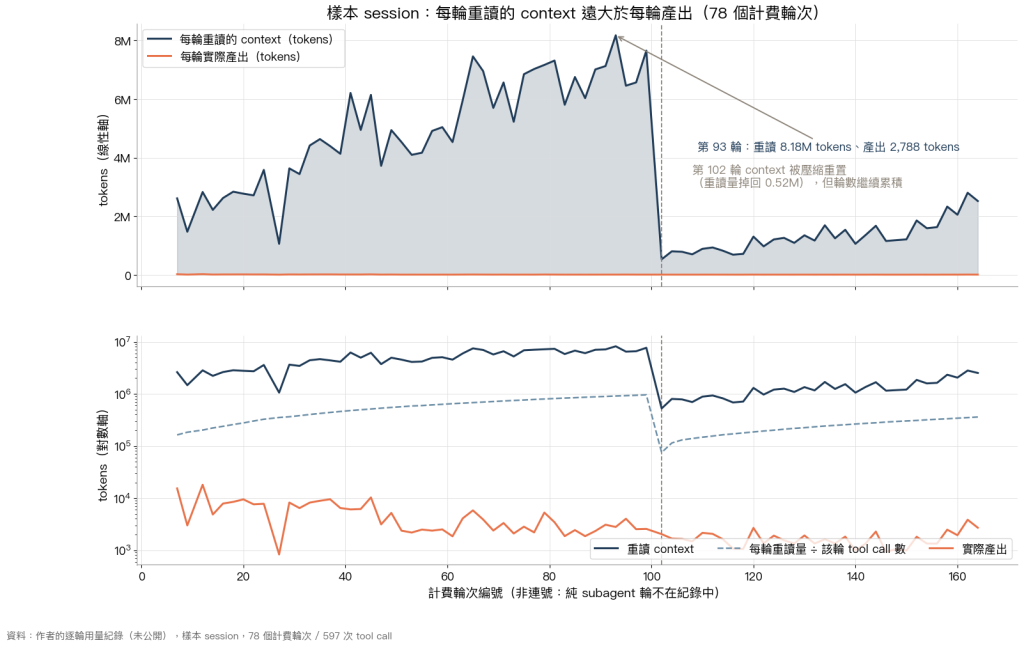
上圖線性軸:藍線是每輪重讀的 context,橘線是每輪實際產出——橘線貼著零軸不是畫錯,它真的只有藍線的千分之一量級。下圖是同一組數字的對數軸,虛線為每輪 context 除以該輪 tool call 數。資料:我的逐輪用量紀錄(未公開)/這場 session。
可以直接對照的點:
同一場 session 的前段也在同一條線上:第 7 輪 16 次 tool call、重讀 2,608,769 tokens、產出 15,344 tokens,該輪等價成本 $1.0229、累計 $3.5235;第 9 輪 8 次 call、重讀 1,468,403 tokens、產出 2,987 tokens。前段每輪重讀兩百多萬,到第 93 輪變成八百多萬。同一場對話、同一個人、同一類工作,愈往後每輪要重付的東西愈多——這就是「膨脹」兩個字實際長的樣子,它不是某一輪突然暴衝,而是重讀量會波動、後段普遍高於前段。
這是我在量級上唯一敢下的結論:同一份持續長大的 context,在 78 個計費輪次裡被一輪又一輪重讀、重複計費。 不是幾次,也不是我原本想像的「每問一句付一次」。至於輪內實際發出幾次模型請求,這份紀錄沒有記,所以 597 次 tool call 不能換算成計費次數。這份資料是輪內累計重讀量,未記錄每輪的模型請求次數,因此無法拆分「請求次數變多」與「單次 context 變大」各佔多少。
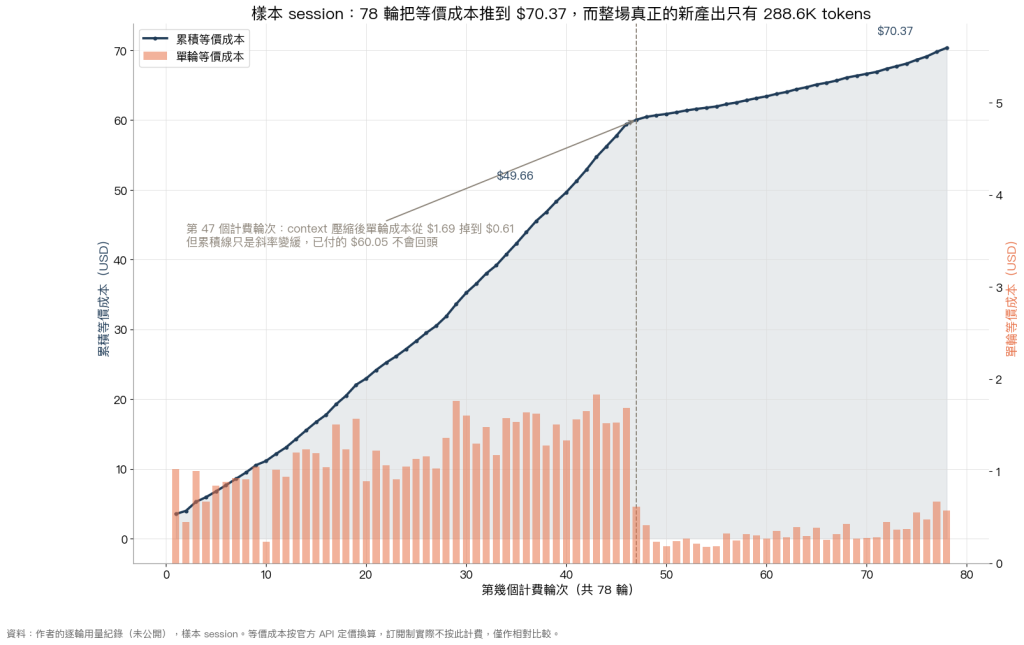
藍線是累積等價成本,橘柱是單輪成本。第 47 個計費輪次(原始輪次編號第 102 輪)的單輪成本由約 $1.69 降至 $0.61;此處標為本文判讀的 context 壓縮位置,僅憑成本下降不能獨立確認壓縮事件。樣本已列出的模型欄為 claude-sonnet-5,完整 78 輪是否同模型仍待核對;金額沿用逐輪用量紀錄在記錄當下依 API 定價換算的等價成本,未附完整費率版本,並非訂閱實付。
疑似壓縮位置之後那 31 輪(第 47 個計費輪次之後至第 78 個計費輪次),單輪成本大幅下降,累積線仍往上爬了 $10.32。壓縮能讓斜率變平,不能讓帳單回頭。
圖二使用我保留的 78 筆逐輪資料,包含輪次、工具呼叫數、非快取 input、重讀量、產出,以及單輪和累計成本。下面三個數字都是從這 78 筆算出來的;資料目前未公開,讀者尚無法逐筆重算,這裡只交代算法:
第一個數字是我最沒預期的。我原本以為帳單會有一個兇手,某一次失控的操作;實際上它是被七十幾次看起來都正常的輪次疊出來的。
舊筆記的放大倍數與本次重算不一致,原計算腳本也已遺失,因此本文不採原倍數,也不以新倍數取代。上面兩張圖由我保留的逐輪資料繪製,即使重產圖表,也只能核對繪圖與計算,不能單獨證明這份資料完整還原了歷史。
可以調整的至少有三項:輸出長度、每次請求帶入的 context,以及需要模型接續判斷的次數。288K output 與 272M 重讀量是 token 數比較;輸出與快取讀取單價不同,不能直接用這個比例判定成本占比,更不能說縮短輸出沒有影響。壓縮 context 能影響後續請求,但可能損失脈絡;減少不必要的往返,則能減少再次攜帶 context 的機會。因此我優先檢查主控是否在反覆處理不需要整場脈絡的機械工作。
解法方向於是浮現:把「哪些輪次根本不該發生在主控手上」這件事移出主控。
主控之所以貴,是因為它背著整場對話的完整脈絡。這份脈絡對「決定下一步」是必要的,對「把 40 個檔案各跑一次 lint」則完全是浪費——後者不需要知道前面 90 輪講過什麼。
Day 2 那筆主控反覆執行 Bash 的歷史紀錄,讓我想到一個可以先改的地方:把不需要整場脈絡的機械工作交出去。我沒有原始對話紀錄檔,不能進一步斷定其中多少次必須由主控執行,也不能據此計算確切節省量。
明天接著看工作怎麼交接:主控交付規則與驗收條件,worker(被派出去做事的 subagent)執行後交回可核對的結果。


 iThome鐵人賽
 看影片追技術